Когда исследователи университета Беркли начинали разрабатывать
Spark,
они держали в голове уже сложившуюся к тому времени картину мира
больших данных – принцип параллельных вычислений на кластере
компьютеров, способном к расширению в ширину, позволял работать с
большими объемами информации, но жертвовал скоростью работы в пользу
горизонтальной масштабируемости и способности к быстрому восстановлению
после системных ошибок. Здесь стоит вспомнить о нашумевшей (и до сих пор
популярной) технологии
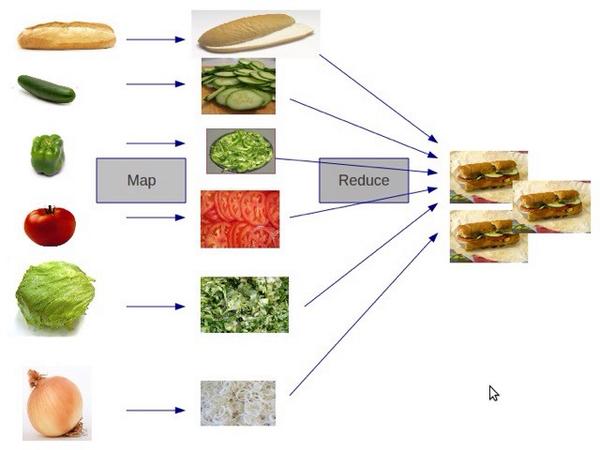
MapReduce, которая примерно до февраля этого года была основной движущей силой экосистемы
Apache Hadoop. Действительно эффективная для пакетной обработки данных, эта модель, однако, обладает существенными недостатками.